文献解读 | 多层超表面矢量模式转换器:把六路光束耦合成少模光纤模式
一句话结论:三层超表面在 0.19 mm² 芯片内折返,把六路光束变成少模光纤的六个模式,实测匹配 −4.5~−3.7 dB。
论文简介
2025 年 8 月,东京大学工学院的 Go Soma、Kento Komatsu、Yoshiaki Nakano 与 Takuo Tanemura 在 Nature Communications 发表 Complete vectorial optical mode converter using multi-layer metasurface(多层超表面实现完整矢量模式转换;DOI: 10.1038/s41467-025-62401-w,开放获取)。文章发表于第 16 卷、文章号 7744。
一句话贡献:作者把多平面光转换(multi-plane light conversion,MPLC)的“相位面 + 自由空间传播”叠层结构折叠到一块芯片里,用三层反射式超表面和伴随优化,把六路自由空间输入变换成少模光纤(few-mode fiber,FMF)的三个空间模式、两个偏振态;实测模式匹配为 −4.5~−3.7 dB,串扰低于 −15 dB,并进一步用六层超表面数值设计了一个把模式解复用、偏振分束和 90° 光混频合在一起的相干接收前端。
这篇论文值得单独读的地方,不是“又做了一个超表面模式复用器”,而是它把“多层”这件事真正做进了芯片厚度:三层相位面不需要分别对准,光在衬底内往返时依次经过它们,层与层之间的传播由衬底厚度自然提供。理解了这一点,才能看懂它为什么能同时控制波前和偏振,也才能判断实测的 10~11 dB 总损耗到底说明了什么。
为什么一片相位面不够
单模光纤的容量增长正在放缓,继续增加传输容量,常用的做法是找新的正交维度。波长、偏振、幅度、相位都已经有成熟的复用技术;空间模式是剩下的一块。少模光纤支持几个不同的横向场分布,这些模式彼此近似正交,可以各自承载一路信号,这就是模分复用(mode-division multiplexing,MDM)。要把这件事做成,链路两端各需要一个模式复用器和解复用器:复用器把每根单模光纤的基模转换成少模光纤中一个指定的模式,解复用器反过来做。
模式复用器的难点不只是“把光送进光纤”。它要在低插入损耗、低串扰的前提下,把每个输入场的振幅、相位和偏振都塑造成目标模式;模式数增加时,器件还要能扩展,最好还能与现有波分复用系统共用波段。几条成熟路线各有取舍。
表 1:几条少模光纤模式复用路线的比较。
| 路线 | 做法 | 优点 | 代价 |
|---|---|---|---|
| 定向耦合器 | 让相邻波导或光纤之间的耦合逐渐把功率转移到目标模式 | 损耗可以做得较低 | 模式数增加时器件变长,制造窗口变窄 |
| 光子灯笼 | 多根单模光纤经过一段绝热过渡,合并到一根少模光纤 | 损耗低,光纤接口自然 | 串扰通常偏高,扩展到更多模式困难 |
| 自由空间 MPLC | 多层相位板与自由空间传播交替,逐层逼近目标波前 | 可合成任意正交空间模式组(标量场),设计自由度高 | 体积大,多层相位板需要精确对准 |
| 本文折叠超表面 | 把多层相位面做在同一块衬底上,光在腔内往返经过它们 | 单块芯片、光刻定义相位面,层间传播由衬底提供 | 损耗、制备精度和带宽仍需改进 |
一张超表面如果只提供一个标量相位面,每个位置只能给入射光一个相位延迟。对于简单的偏折、聚焦,这已经够用;但要把一个高斯模变成 LP11 这种既有强度零点、又需要特定空间对称性的模式,单层相位面能提供的自由度很快就不够。MPLC 的思路是让光在“相位调制”和“自由空间传播”之间交替:相位面把光场切出新的分布,传播让这些分布互相干涉、重新组合,下一层再做修正。层数越多,能逼近的目标模式组越复杂。
问题是,多层相位板如果分别做在不同衬底上,层与层之间就要精确对准;层数一多,对准误差和装调成本会迅速吃掉设计收益。本文的做法是把这些层折回到同一块衬底里:光在衬底内来回反射,每次打到超表面的不同区域,就经历一次相位和偏振变换;两次反射之间的传播,正好由衬底厚度提供。这样,多层 MPLC 的“自由度”还在,但“多层对准”变成了光刻时的平面图形对准。
折叠的多层超表面怎样工作
器件的核心是一块 625 μm 厚的熔融石英衬底。衬底一侧排着三段反射式超表面,另一侧是一面全反射镜;输入和输出孔径分别开在两面。光从输入孔径进入,在超表面与反射镜之间来回反射,依次经过三段超表面,最后从输出孔径出射。三段的横向尺寸各为 192 × 240 μm²,整块芯片约 0.8 × 0.24 mm²,也就是 0.19 mm² 左右。
输入是排成 3 × 2 阵列的六束 X 偏振高斯光束。它们分别对应输出端线偏振(linearly polarized,LP)模式 LP01、LP11a、LP11b 的 X 偏振和 Y 偏振分量:同一空间模式的两个正交偏振各由一路输入产生。于是,器件完成的不是“六路输入变成六个空间模式”,而是“六路单偏振输入变成三个空间模式 × 两个偏振态”的矢量转换。这个口径很重要:论文说的“六模式”是三个空间模式乘两个偏振态,不是六个 LP 空间模式。
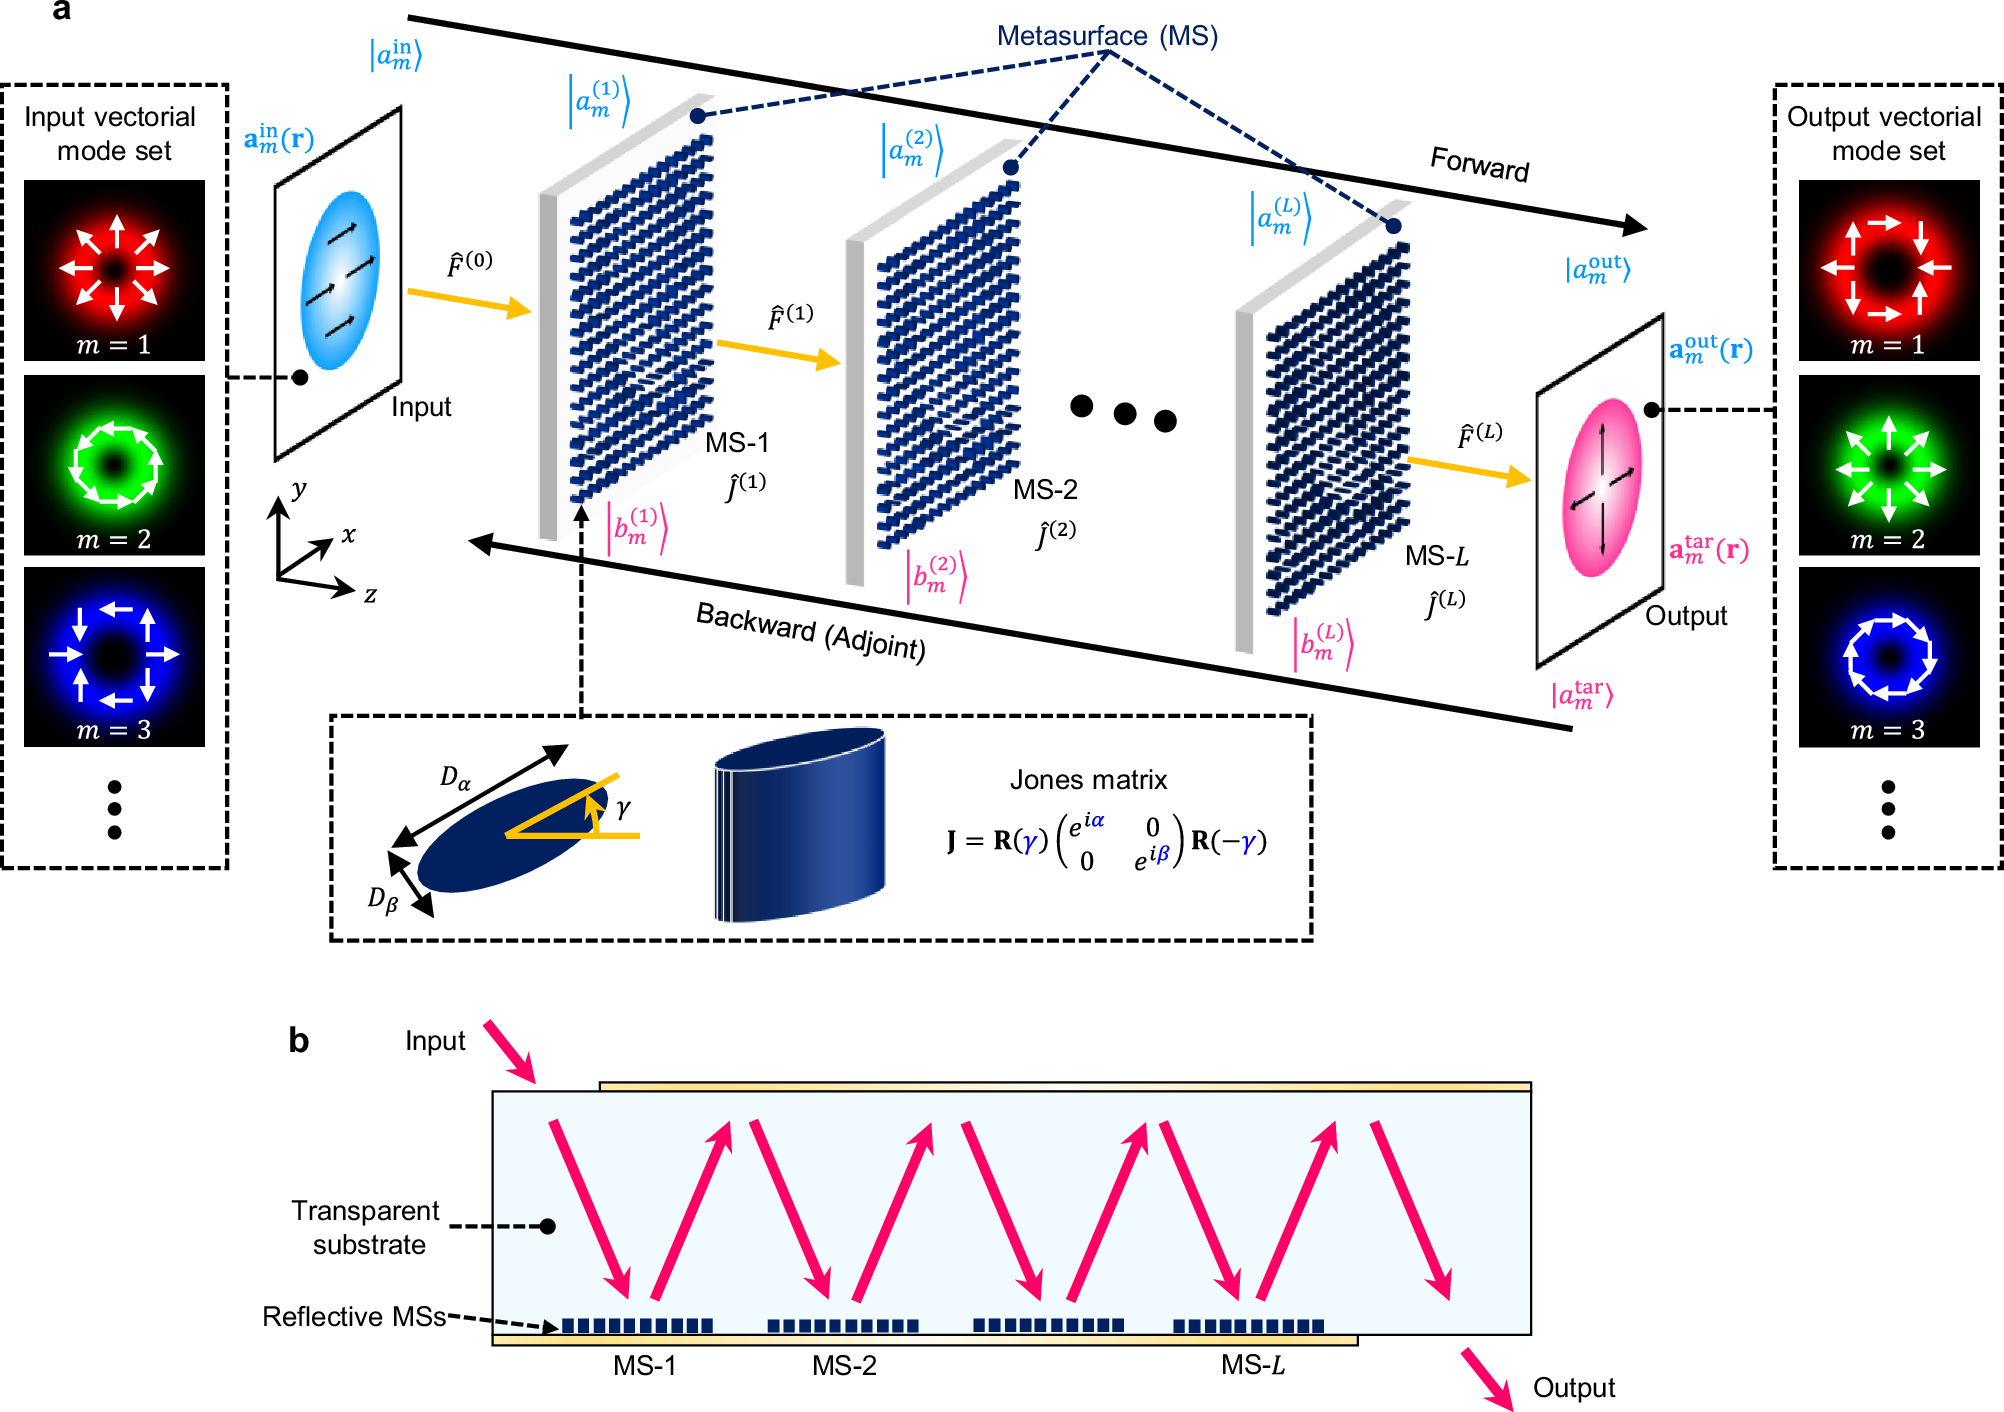
图 1:多层超表面矢量模式转换的概念与折叠结构。(a) 由 L 层超表面与自由空间传播组成的变换器:输入矢量模式组经过逐层相位/偏振调控与传播,变为目标模式组;超表面的 Jones 矩阵用前向场和伴随(反向)场优化。下方插图为双折射元原子,取向角为 γ,两个相移 α、β 由元原子尺寸 Dα、Dβ 决定。(b) 用反射式超表面实现的单芯片折叠结构。
每一段超表面由亚波长元原子排成阵列。元原子是硅椭圆纳米柱,下面依次是熔融石英衬底、聚酰亚胺包层和 Ti/Au 反射镜。光在元原子中往返一次,会获得两个主轴方向上的相移 α、β,以及一个由椭圆长轴取向决定的旋转角 γ。对理想、无损耗、非手性的介质结构,每个元原子可以写成一块极小的双折射波片:
$$ \mathbf{J}^{(l)}(\mathbf{r}_n)= \mathbf{R}(\gamma^{(l)}) \begin{pmatrix} e^{i\alpha^{(l)}} & 0\\ 0 & e^{i\beta^{(l)}} \end{pmatrix} \mathbf{R}(-\gamma^{(l)}), $$
其中 (\mathbf{R}(\gamma)) 是把元原子主轴旋转 γ 的旋转矩阵,(\alpha^{(l)})、(\beta^{(l)}) 是第 l 层在位置 (\mathbf{r}_n) 处沿慢轴和快轴的相移。α、β 由椭圆的长短轴尺寸决定,γ 由椭圆在平面内的朝向决定;三个参数合起来,才让每个像素既能改相位,又能改偏振。这也是它和“只调相位的超表面”最根本的区别:矢量模式转换需要的不只是一张相位图,而是一张随位置变化的 Jones 矩阵图。
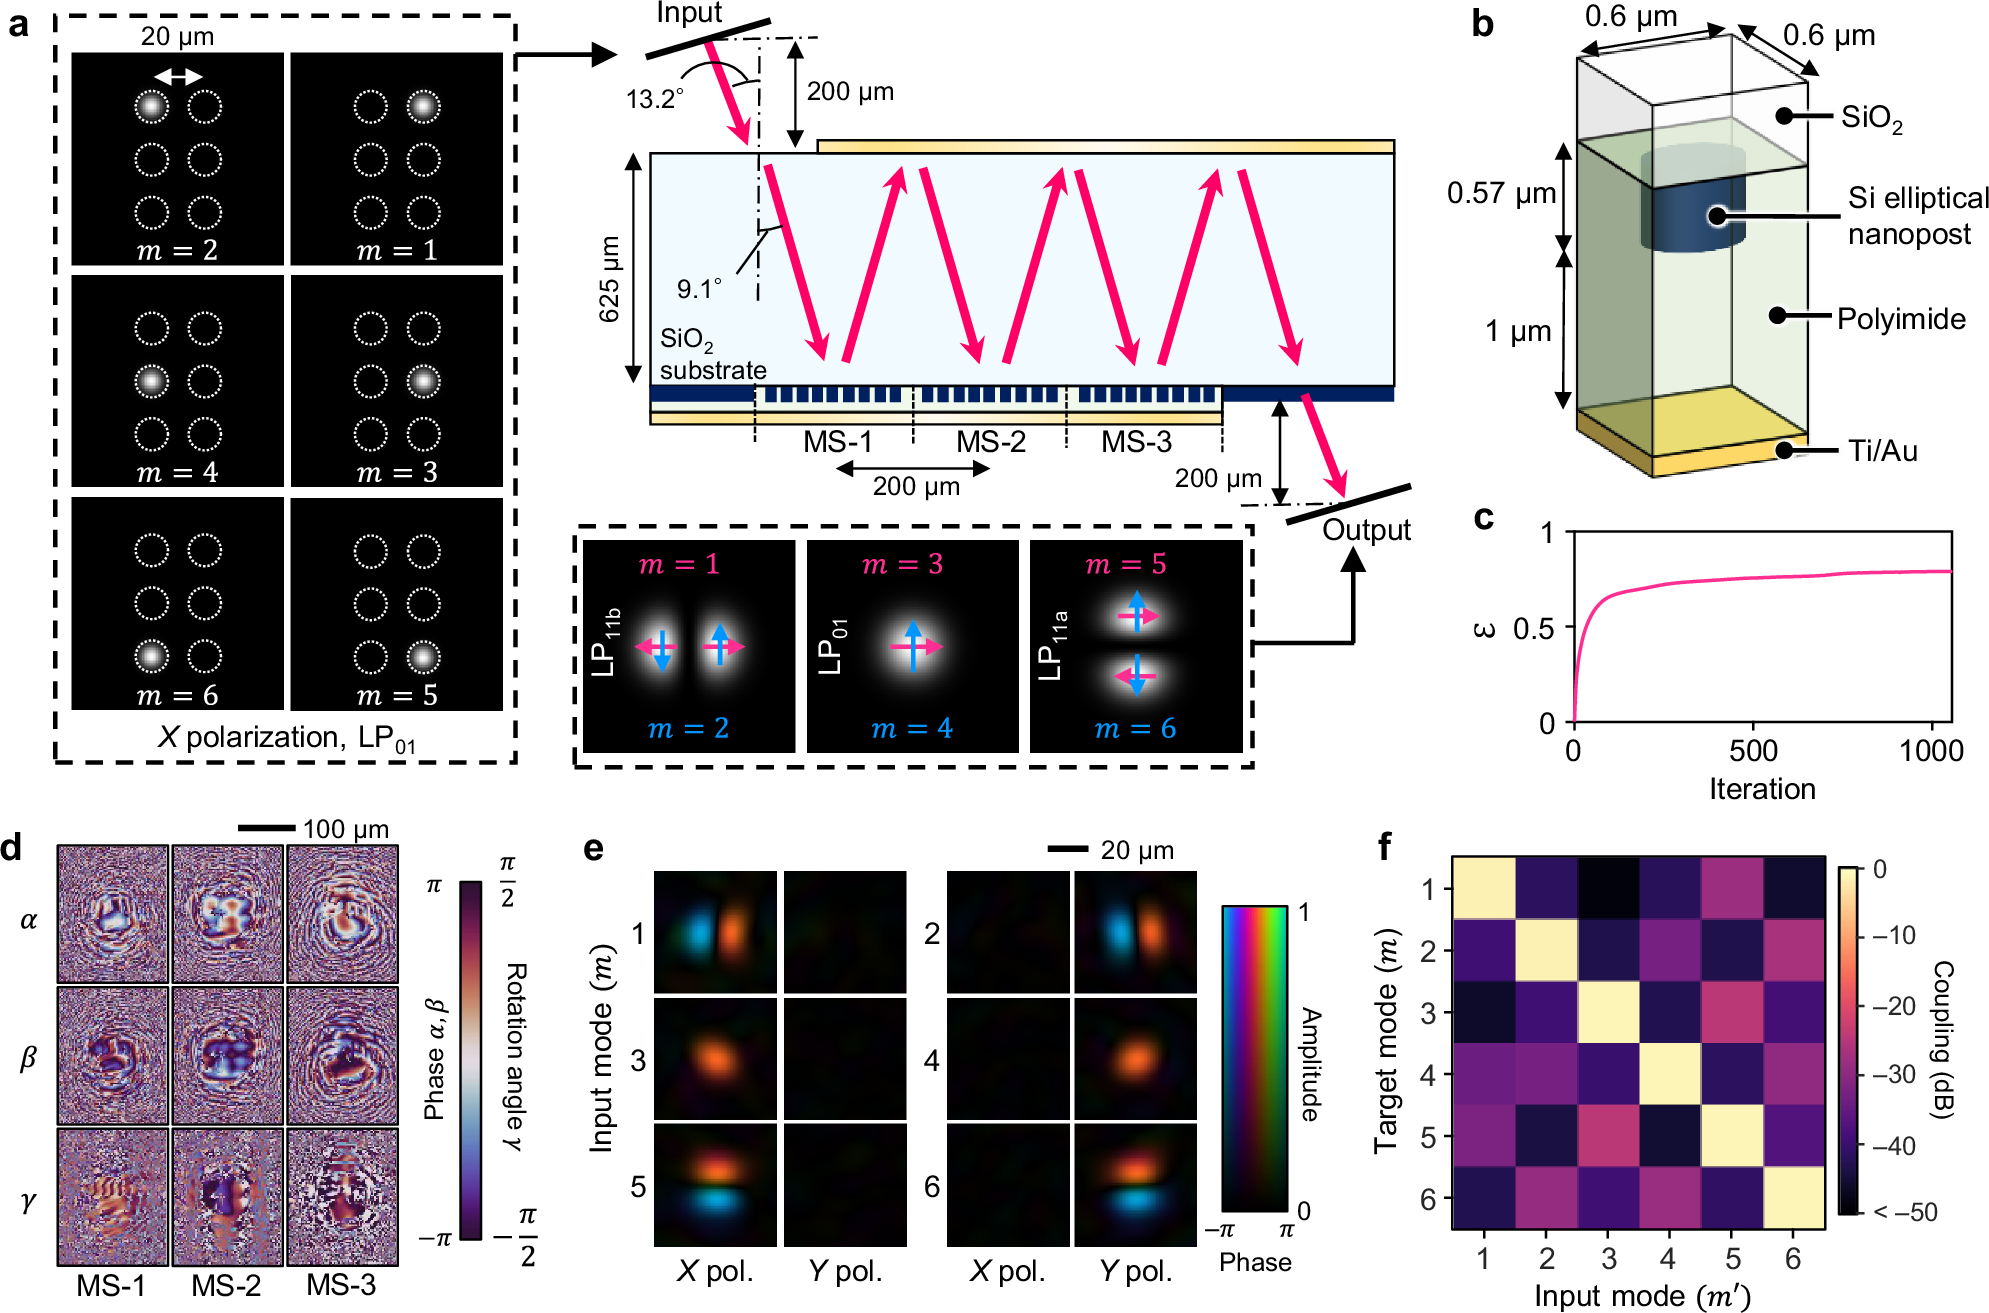
图 2:六模式(3 个空间模式 × 2 个偏振态)复用器的结构与设计。(a) 器件结构:光在三个反射式超表面段之间多次反射,六束 X 偏振输入被转换为偏振复用的 LP 模式。(b) 反射式元原子:SiO₂ 衬底上的硅椭圆纳米柱,上方为聚酰亚胺与 Ti/Au 反射镜。(c) 优化过程中目标函数 (\mathcal{E}) 的收敛曲线。(d) 优化后三层超表面的参数 (\alpha^{(l)}(\mathbf{r}))、(\beta^{(l)}(\mathbf{r}))、(\gamma^{(l)}(\mathbf{r})) 的空间分布。(e) 每个输入模式对应的输出复场分布。(f) 计算得到的耦合效率矩阵 C。
设计:用伴随法反推每个元原子
三层超表面、每层 320 × 400 个采样点,每个点又有 α、β、γ 三个参数,整个器件的设计空间有上百万个变量。靠手算或参数扫描不可能找到解;论文用的是伴随法(adjoint method)做逆设计。
先定义目标函数。设第 m 个输入对应的目标输出场为 (|a_m^{\mathrm{tar}}\rangle),实际输出场为 (|a_m^{\mathrm{out}}\rangle),M 为输入/输出模式对的数量,则优化的目标是让两者的重叠尽可能大:
$$ \mathcal{E}= \frac{1}{M}\sum_{m=1}^{M} \left|\langle a_m^{\mathrm{tar}}|a_m^{\mathrm{out}}\rangle\right|^2. $$
这个目标函数只要求“输出场像目标场”,并不直接惩罚串扰;论文的解释是,如果每个模式都转换得足够准,串扰自然会低。实际计算时,前向传播给出每个像素处的场,反向传播把目标场送回同一位置;把前向场和伴随场做一次内积,就能得到目标函数对该像素三个参数的梯度。一次前向加一次反向,所有像素的梯度同时得到,不需要对上百万个变量逐个做有限差分。拿到梯度后,沿梯度方向迭代更新,论文报告大约 1000 次迭代后收敛。
优化得到的是理想 Jones 矩阵参数 α、β、γ。要把它们变成可制造的椭圆纳米柱,还需要用严格耦合波分析(rigorous coupled-wave analysis,RCWA)扫描不同长轴尺寸 Dα、短轴尺寸 Dβ 和几何取向角 γ′ 的反射响应,建立参数库,再为每个像素挑出最接近目标的几何参数。由于光在腔内是斜入射,理想的 γ 和实际的几何取向 γ′ 并不完全相等,这一步需要单独修正。元原子按 600 nm 周期排布,工作在 1550 nm。
仿真给出的上限是:六模式复用器在 1550 nm 的插入损耗低于 0.85 dB,任意通道之间的串扰低于 −22 dB。图 2(f) 的耦合效率矩阵 C 对角元明显高于非对角元;这说明在理想 Jones 矩阵和理想传播模型下,三层结构确实能把这组矢量模式分开。接下来要看实际器件。
测量:模式匹配、串扰与总损耗
器件制作在石英上硅(silicon-on-quartz,SOQ)衬底上,硅层厚 0.57 μm。超表面图形用电子束曝光写入,再用 Bosch 工艺刻蚀硅,随后旋涂聚酰亚胺、沉积 Ti/Au 反射镜,并在两面开输入/输出孔径。整块芯片仍然是 0.8 × 0.24 mm² 左右。论文用光学显微镜和扫描电子显微镜(scanning electron microscope,SEM)检查了超表面与孔径的形貌。
测量在 1550 nm 进行。单模光纤以 13.2° 入射到输入孔径,输出端用 20 倍红外物镜和 4f 系统成像到 InGaAs 相机;参考光与信号光在相机上干涉,通过切换参考光的 X/Y 偏振,分别重建输出场的两个偏振分量。这就是离轴数字全息:相机记录的是干涉条纹,不是直接的强度图,条纹的相位里带着输出场的相位信息。
把测得的复场与目标场做归一化重叠,得到模式匹配矩阵 S:
$$ S_{mm'}= \frac{\left|\langle a_m^{\mathrm{tar}}|a_{m'}^{\mathrm{meas}}\rangle\right|^2} {\langle a_{m'}^{\mathrm{meas}}|a_{m'}^{\mathrm{meas}}\rangle}. $$
这里的分母是第 m′ 路实测输出自身的功率,所以 S 衡量的是“形状有多像”,不是“从输入到输出损失了多少功率”。实测对角元为 −4.5~−3.7 dB,也就是 36%~43% 的归一化重叠;非对角串扰低于 −15 dB。器件的透射率约为 −7 dB,把透射率和模式失配合起来,总损耗约为 10~11 dB。
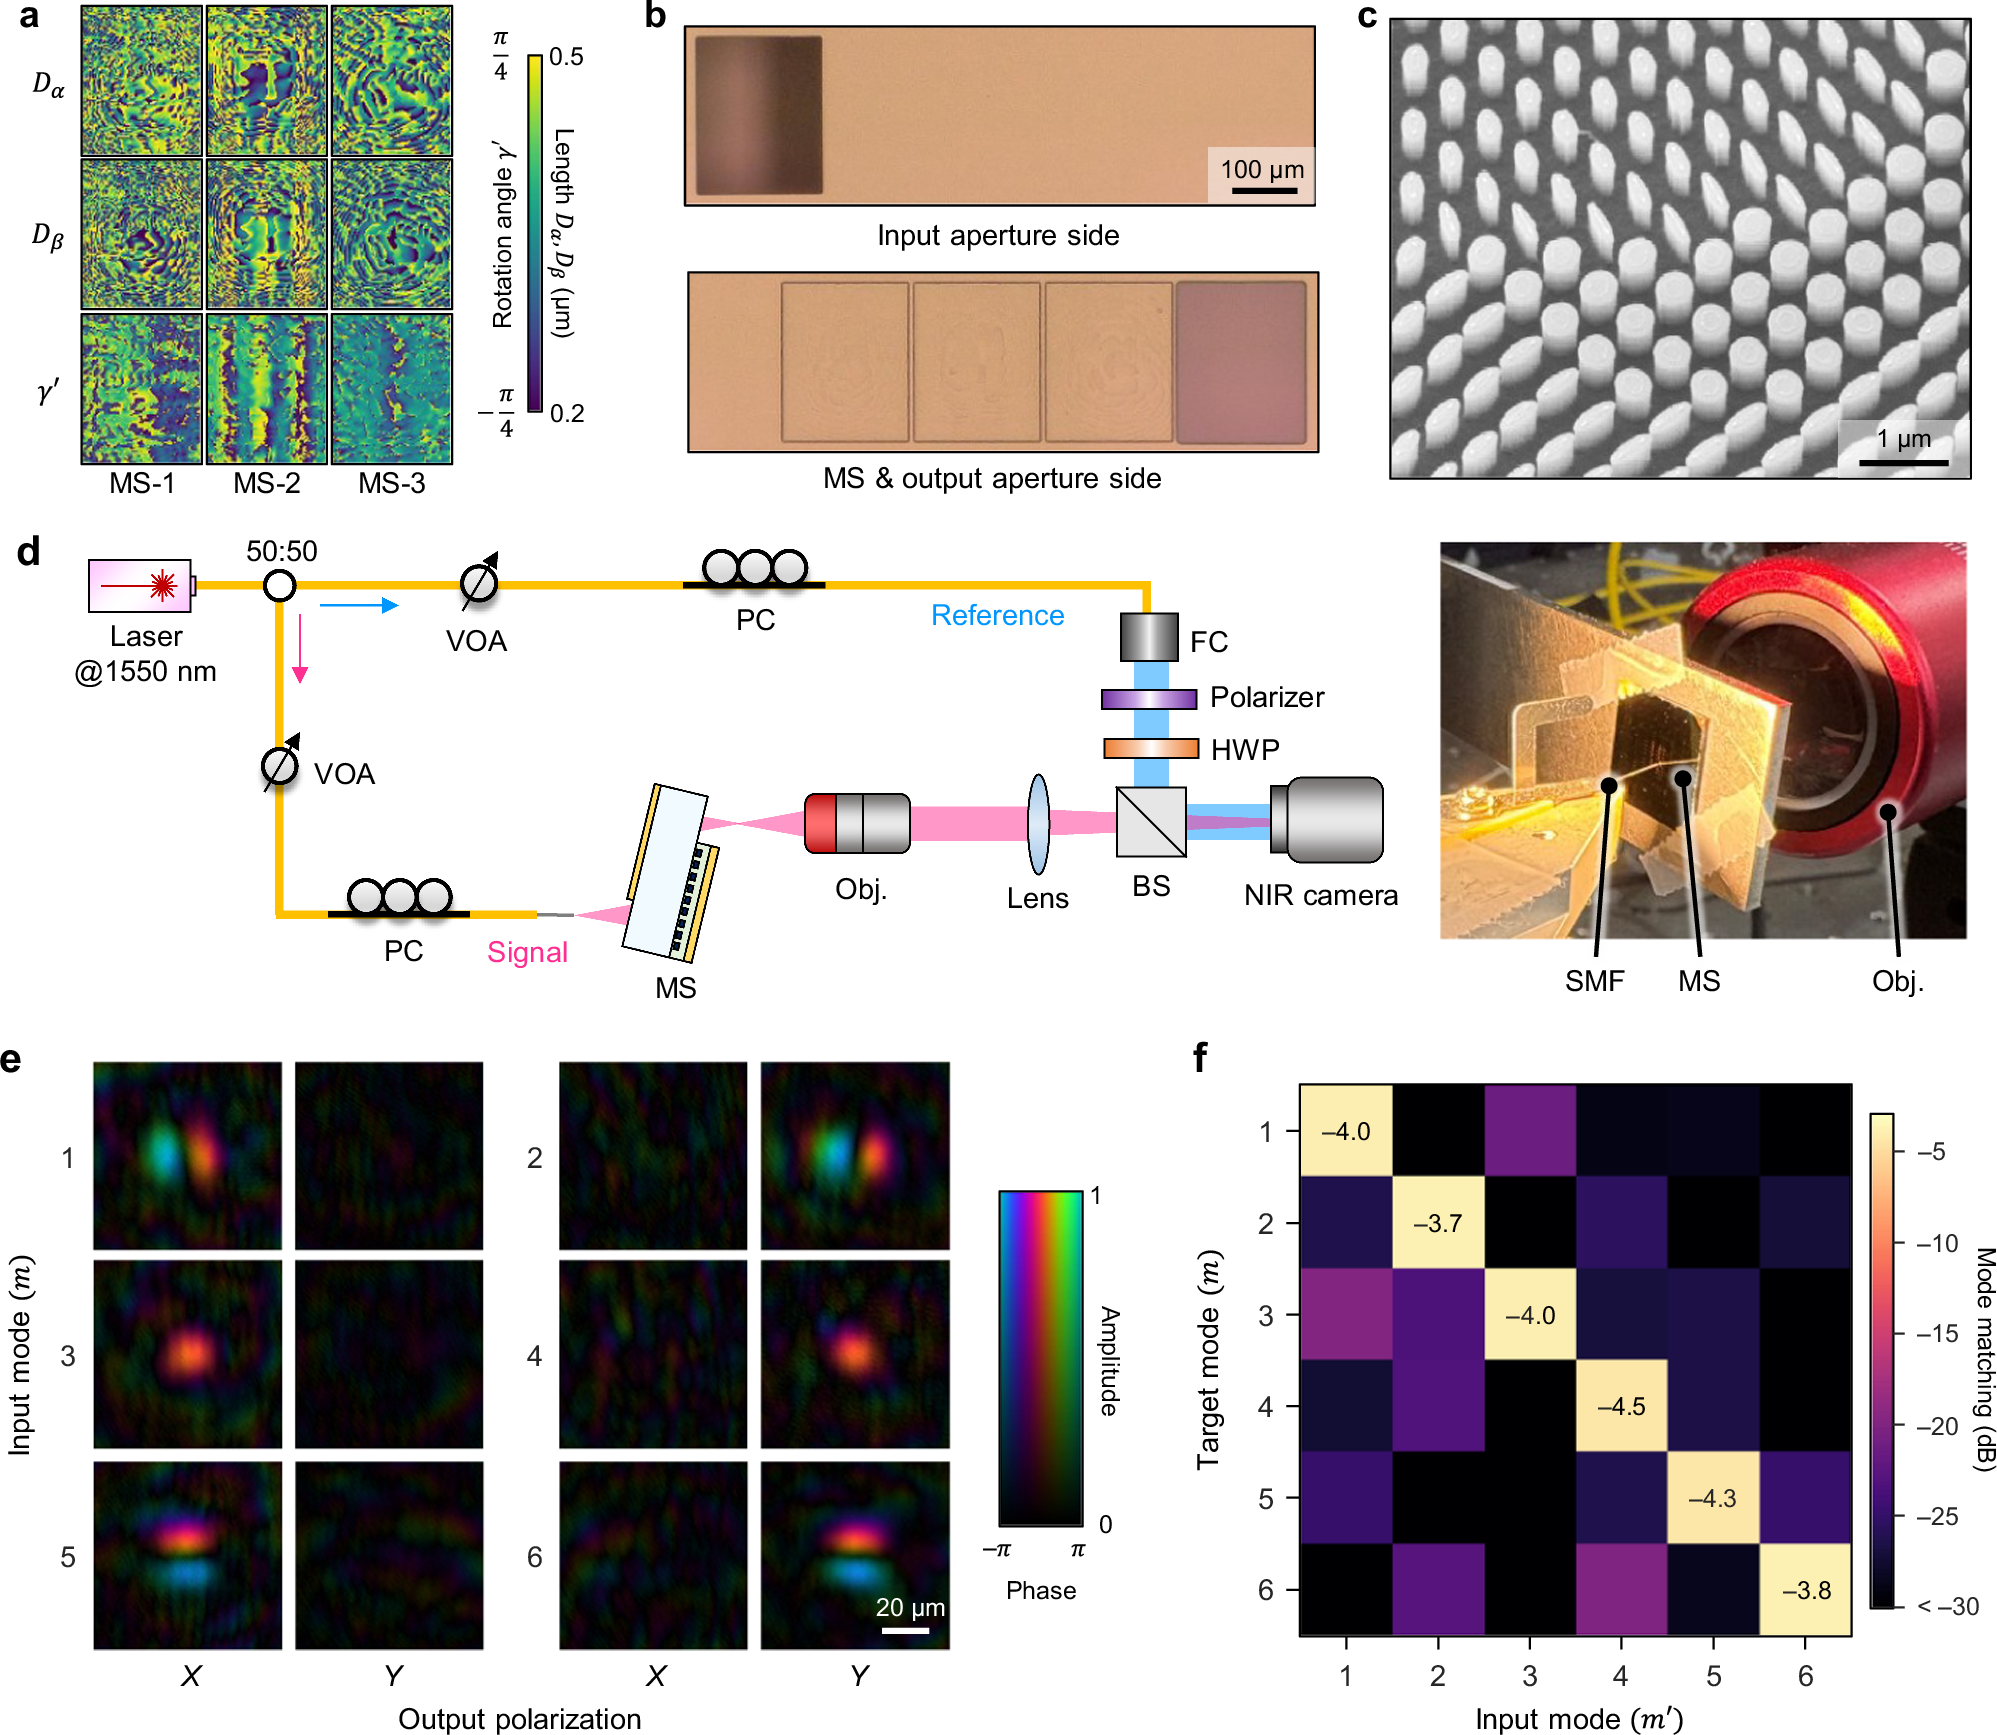
图 3:六模式复用器的实验表征。(a) 元原子几何参数 Dα、Dβ、γ′ 的分布。(b) 制备器件的显微图像:下方为超表面与输出面,上方为输入面。(c) 沉积聚酰亚胺之前的超表面 SEM 图像。(d) 测量装置:VOA 可调衰减器、PC 偏振控制器、Obj. 物镜、Pol. 偏振片、FC 光纤准直器、HWP 半波片、BS 分束器、NIR 近红外;右侧插图为芯片、输入单模光纤与物镜的照片。(e) 输出面 X/Y 偏振的实测复场分布。(f) 实测模式匹配矩阵 S。
实测和仿真的差距不小:仿真插损低于 0.85 dB,实测总损耗 10~11 dB。论文把原因归到几处:硅纳米柱的几何尺寸和聚酰亚胺层厚度有偏差,聚酰亚胺表面不平整会在沉积金反射镜时把起伏印到相位面上;Ti/Au 有吸收和散射;光纤与输入孔径的对准、入射角偏差也会让输出场偏离目标。换句话说,这一版器件验证的是“三层折叠 + 矢量转换”能不能工作,不是“损耗已经优化到可用”。
从复用器到相干接收前端
模式复用器只是链路的一半。在模分复用的相干接收端,还需要把不同空间模式分开、把每个模式的两个偏振分开,并让每个模式与本地振荡光做 90° 混频,才能同时读出同相和正交分量。传统做法要用空间模式解复用器、偏振分束器(polarization beam splitter,PBS)和每个模式一套 90° 光混频器,器件多、对准复杂。
论文用同一套多层超表面框架,设计了一个把这些功能合在一起的接收前端。器件由六层超表面组成,每层 192 × 300 μm²,层间间隔 200 μm。输入是少模光纤的 LP01、LP11a、LP11b 三个空间模式(模场直径 15 μm)和一路单模光纤的 LP01 本振(local oscillator,LO,模场直径 10.4 μm),两束光纤间隔 127 μm。六个信号模式与一路本振在输出面被聚焦到 24 个点:每个信号模式占 4 个点,四个点的相对相位依次为 0、π/2、π、3π/2;本振被分成 24 份等功率、等相位的点。把光电探测器(photodiode,PD)放在这 24 个位置上,就能对六个信号同时做平衡探测。
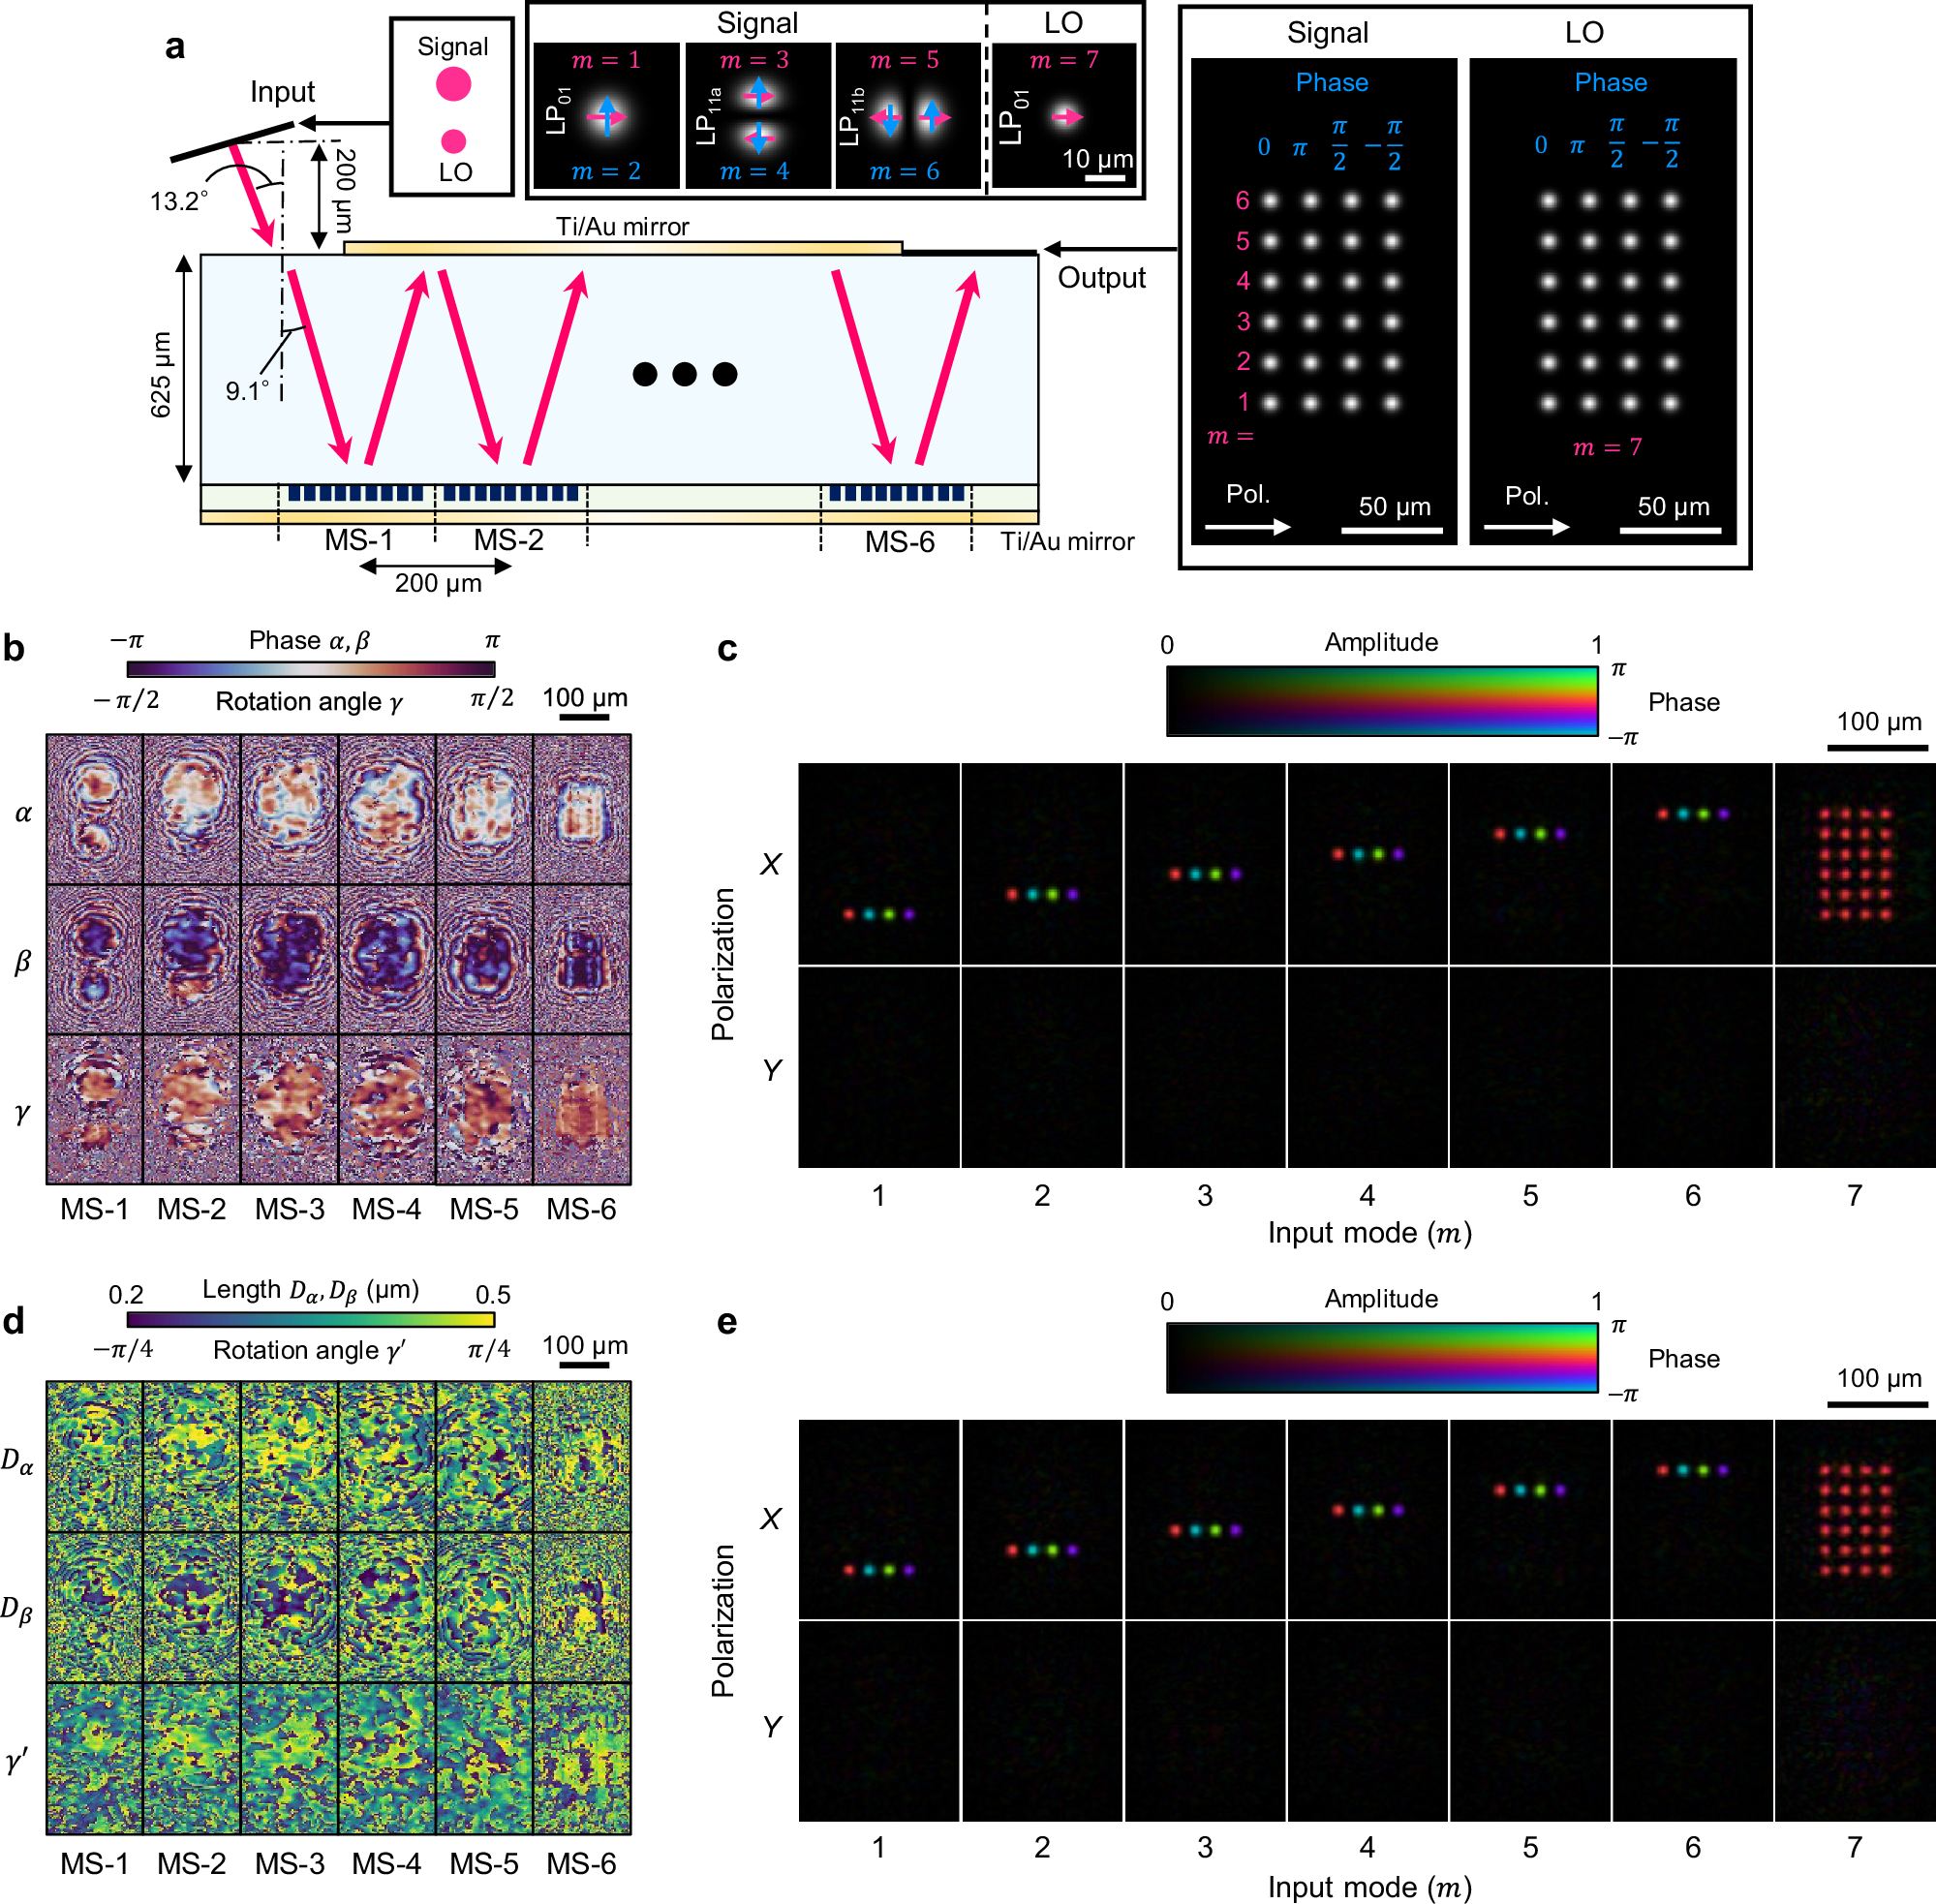
图 4:MDM 双偏振相干接收前端。(a) 六层超表面构成的接收前端:输入为 LP01、LP11a、LP11b 信号与 LP01 本振,输出面为 24 个点,每个信号模式的四个点相位依次为 0、π/2、π、3π/2;相邻点间距 20 μm,聚焦光斑直径 10 μm。(b) 优化后的六层超表面参数 α、β、γ。(c) 各输入模式在输出面的矢量场分布。(d) 元原子几何参数 Dα、Dβ、γ′ 的分布。(e) 用实际元原子反射矩阵计算得到的输出场分布。
在理想 Jones 矩阵下,这个接收前端的仿真插入损耗低于 0.9 dB,模式相关损耗(mode-dependent loss,MDL)为 0.03 dB,串扰低于 −23 dB,四个点之间的相位误差低于 4°,功率不平衡低于 0.92 dB;在 1530–1565 nm 的 C 波段内性能没有明显退化。把理想 Jones 矩阵换成实际元原子的 RCWA 反射矩阵后,插入损耗增加到约 2.7 dB,串扰低于 −24 dB,相位误差约 4.2°,功率不平衡约 1.1 dB。这个接收前端目前只有数值设计,没有制备和实测;正文说“设计”而不是“实现”,区别就在这里。
这些数字说明什么
把三个口径放在一起,才能读懂这篇论文的实测结果。
表 2:模式匹配、插入损耗与串扰的区别。
| 指标 | 定义 | 本文结果 | 读法 |
|---|---|---|---|
| 模式匹配 (S_{mm}) | 输出场与目标场的归一化重叠,分母是实测输出功率 | −4.5~−3.7 dB(36%~43%) | 衡量“形状像不像”,不含总功率损失 |
| 总插入损耗 | 输入功率到目标输出模式的功率损失 | 10~11 dB | 系统最关心的损耗,含 −7 dB 透射率与模式失配 |
| 串扰 | 漏到错误模式的功率 / 目标模式功率 | 低于 −15 dB(低于 3.2%) | 衡量模式隔离度,不是总损耗 |
| 仿真插入损耗 | 理想 Jones 矩阵下的设计上限 | 低于 0.85 dB | 说明设计潜力,不是实测 |
最容易被误读的是 −3.7 dB。它看起来像“插损只有 3.7 dB”,实际上它只是模式匹配:输出场的形状与目标场有 43% 的归一化重叠。器件还有约 −7 dB 的透射率,也就是只有约 20% 的输入功率从输出孔径出来;两者相乘,才是 10~11 dB 的总损耗。把模式匹配当成插损,会高估器件性能约 7 dB。
串扰的读法也不同。−15 dB 对应约 3.2% 的功率漏到错误模式;这个数字说明模式隔离度已经可用,但它不告诉你总损耗,也不告诉你接收端经过均衡后能不能把误码率压下去。论文没有做传输实验,没有给 BER 或星座图,所以“能不能支持多少 Tbit/s”不能从这篇的实测数据直接推出来。它给出的是器件层面的模式转换证据,不是系统层面的容量结论。
那为什么仿真 0.85 dB、实测 10~11 dB,差了一个数量级?论文的分析集中在制备和测量:硅纳米柱的尺寸偏差、聚酰亚胺包层厚度不均、金反射镜把包层起伏印成相位误差、Ti/Au 的吸收与散射、光纤和孔径的对准、13.2° 入射角的偏差。这些因素在仿真里都被理想化了。论文也明确说,总插入损耗高于其他模式复用方案,制备、纳米柱设计和包层工艺都有改进空间。换句话说,这一版器件证明的是“三层折叠 + 矢量转换”能工作,不是“损耗已经可以进系统”。
这也是读这篇论文时应该保持的尺度:它的新意在架构和设计方法,不在损耗纪录。三层相位面折进一块芯片、每个像素用三个参数同时控制相位和偏振、再把同一套框架推到相干接收前端,这些是它相对单层相位面方案多出来的东西。至于 10 dB 的损耗能不能降下来,要看后续的工艺和封装,不是这篇的实测能回答的。
适用边界与待推进方向
先分清哪些是实测、哪些是设计。六模式复用器有制备、有实测:模式匹配、串扰、透射率都来自 1550 nm 的离轴全息测量。相干接收前端的 24 个点、0.9 dB 插损、−23 dB 串扰是数值设计;换成实际元原子后插损约 2.7 dB,但仍然没有制备和实测。把这两部分混在一起,就会把“设计上可行”说成“已经实现”。
带宽也有类似的口径差异。复用器只在 1550 nm 做了测量,没有给出整个 C 波段的实测曲线;接收前端的 1530–1565 nm 表现是仿真。论文的接收前端设计覆盖 C 波段,但复用器的实测只有 1550 nm 这一个点。对波分复用系统来说,带宽和色散需要单独的实验数据,不能从单波长结果外推。
偏振口径同样需要说清。输入是六束 X 偏振高斯光束,输出是三个空间模式的两个正交偏振;器件完成的是“单偏振输入 → 双偏振输出”的转换,不是一个对任意输入偏振都无差别的器件。要让两个偏振都作为独立通道,输入偏振必须被控制和稳定。论文的实测也只覆盖了 X 偏振输入,没有给出双偏振同时工作的传输实验。
再往外推,还有几件事没有解决。输入和输出都是自由空间光束,光纤与孔径的对准靠六轴位移台;要变成可封装的模块,需要光纤阵列、主动/被动对准和更稳定的机械结构。器件的损耗主要来自制备误差和材料吸收,聚酰亚胺包层的平坦化、低损耗包层、更精确的纳米柱参数库都是可改进的方向。模式数增加时,相位面面积和层数都会增加,设计空间和制备难度随之上升;论文称在补充材料里数值验证了 12 模式复用器,但没有给出与六模式器件同等详细的实测。把这些边界说清楚,不会削弱论文的价值,反而能说明它处在从原理验证走向工程器件的哪一段。
意义与展望
这篇论文把 MPLC 的“多层”从实验台上的分立相位板,折叠到了一块 0.19 mm² 的芯片里。它的直接贡献是给出了一套可扩展的设计框架:每层超表面用 α、β、γ 三个参数控制相位和偏振,层间用自由空间传播混合波前,再用伴随法把整个多层结构一起优化。这个框架不只适用于六模式复用器,也被用来设计相干接收前端和空间模式复用的矢量全息;后者说明同一套“多层 + 矢量”思路可以承载更一般的空间模式变换。
对光通信来说,意义在于它把“模式转换”从单个器件的指标,推进到了“复用器 + 接收前端”的链路层面。传统 MDM 相干接收需要模式解复用器、偏振分束器和多套 90° 混频器;如果这些功能能由一块多层超表面完成,接收端的体积、对准复杂度和通道间的一致性都有机会改善。当然,这还取决于损耗能不能降下来、封装能不能做稳、带宽能不能覆盖整个 C 波段。
从原理验证走向实际应用,接下来最值得看的三件事是:把总损耗从 10 dB 量级降到系统可接受的范围,把自由空间输入/输出变成可封装的光纤接口,以及在更宽波段上验证多层结构的色散和串扰。论文已经给出了设计方法和第一版实验证据;这三件事决定它能不能从“芯片上的演示”变成“链路里的器件”。
参考资料
- Soma, G., Komatsu, K., Nakano, Y. & Tanemura, T. Complete vectorial optical mode converter using multi-layer metasurface. Nature Communications 16, 7744 (2025). DOI · PMC 全文
- Wang, Z. et al. Metasurface on integrated photonic platform: from mode converters to machine learning. Nanophotonics 11, 3531–3546 (2022). DOI
- Rademacher, G. et al. Peta-bit-per-second optical communications system using a standard cladding diameter 15-mode fiber. Nature Communications 12, 4238 (2021). DOI
- Miller, D. A. B. Waves, modes, communications, and optics: a tutorial. Advances in Optics and Photonics 11, 679–825 (2019). DOI
- Birks, T. A. et al. The photonic lantern. Advances in Optics and Photonics 7, 107–167 (2015). DOI
- Oh, J. et al. Adjoint-optimized metasurfaces for compact mode-division multiplexing. ACS Photonics 9, 929–937 (2022). DOI